Gli embedding spiegati a chi progetta l’architettura dell’informazione
Qualche giorno fa Stefano Bussolon, psicologo, ricercatore UX e docente di HCI, ha lanciato su LinkedIn tre domande secche: quante persone si occupano di UX e architettura dell’informazione, quante di queste vogliono farsi aiutare dagli LLM in quel lavoro e, infine, quante sanno cosa sono gli embedding. L’imbuto è eloquente: ogni passaggio restringe il gruppo e l’ultimo, sospetto, lascia in pochi.
Quando andavo al liceo, la mia professoressa di italiano del biennio parlava spesso di campi semantici. All’epoca il concetto mi sembrava ancora un po’ astratto, quasi filosofico. Oggi la ringrazio per quella prospettiva avveniristica, perché gli embedding sono, in fondo, campi semantici tradotti in numeri.
Cosa sono gli embedding, in parole semplici
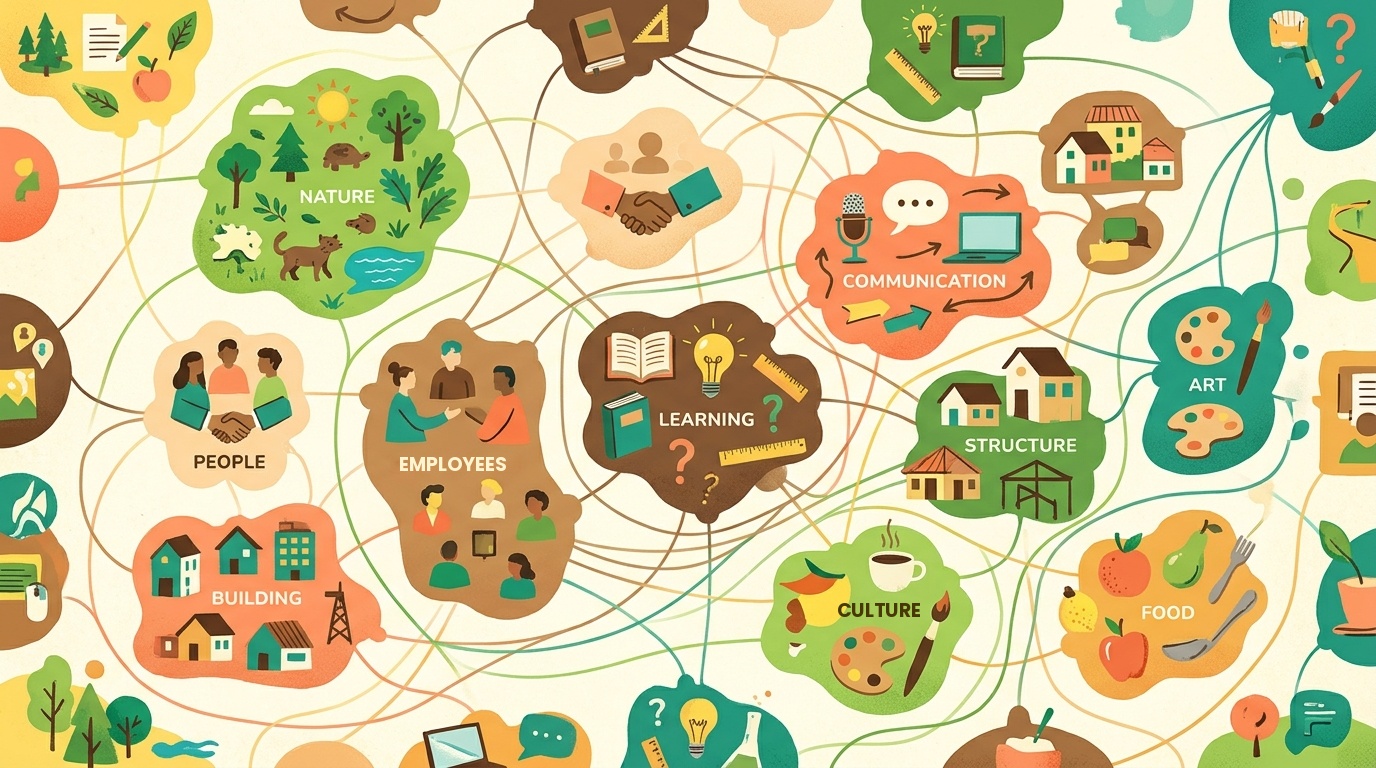
Un embedding è una rappresentazione numerica di un contenuto: una parola, una frase, un paragrafo, un’immagine. Il modello trasforma quel testo (o quella figura) in un lungo elenco di numeri, un vettore, che funziona come un insieme di coordinate. Ciascun elemento finisce così in un punto preciso di uno spazio con centinaia o migliaia di dimensioni.
La proprietà decisiva riguarda le distanze: elementi dal significato affine si collocano vicini, quelli lontani per senso restano separati. “Bagaglio” e “valigia” abitano lo stesso quartiere, “bagaglio” e “mutuo” decisamente no. La prossimità si misura con un calcolo, di solito la similarità del coseno, quindi diventa confrontabile, ordinabile e raggruppabile.
Da word2vec agli LLM: una breve storia
L’idea affonda le radici nella linguistica distribuzionale degli anni Cinquanta, riassunta dalla celebre intuizione di J.R. Firth: una parola si conosce dalla compagnia che frequenta. Nel 2013 Tomas Mikolov e il suo gruppo in Google hanno presentato word2vec, che rendeva rapido e accessibile il calcolo di questi vettori a partire da enormi quantità di testo.
Da allora i modelli sono cresciuti parecchio. Oggi rappresentano frasi e documenti interi, tengono conto del contesto e lavorano anche su immagini e audio. In pratica, sono il modo in cui gli LLM “leggono” ciò che gli diamo in pasto.
Perché riguardano l’architettura dell’informazione
Chi si occupa di architettura dell’informazione organizza, etichetta e rende trovabili i contenuti. Per farlo usa strumenti come il card sorting, in cui le persone raggruppano voci su schede secondo la propria logica, e l’analisi dei cluster che ne deriva. Alla base c’è sempre una domanda: cosa sta vicino a cosa, nella mente di chi userà il sistema?
Gli embedding offrono una risposta parallela, cioè cosa sta vicino a cosa nello spazio statistico costruito da un modello. È la pista che Bussolon dice di esplorare da tempo, con qualche prova su dati fittizi: definire uno spazio semantico in cui clusterizzare gli elementi di un dominio e ricavarne indicazioni per progettare la struttura.
Le esperienze raccontate nei commenti
Sotto il post si sono fatti avanti diversi professionisti, e due testimonianze hanno dato concretezza al tema.
Chips dinamiche in un chatbot per l’aeroporto
Andrea Turco, Head of Design, ha raccontato un progetto di assistenza ai passeggeri in aeroporto. A partire dalla richiesta dell’utente, il chatbot generava suggerimenti cliccabili semanticamente coerenti: alla domanda sull’imbarco comparivano opzioni come check-in, bagaglio o difficoltà motoria. Dietro c’era un lavoro enorme di chunking su anni di feedback raccolti. Secondo Turco l’esperienza ne ha guadagnato molto, perché evitava dialoghi snervanti, grazie alla velocità e all’accuratezza delle proposte.
Ricerca, chat e contenuti correlati
Marco Trevisan, fondatore di Bazzmann e Venipedia, impiega gli embedding per tre funzioni: ricerca, interrogazione via chat con RAG e suggerimento di materiali correlati. Gli ambiti sono una documentazione interna, un’enciclopedia multimodale e un archivio accademico. La sua lezione principale: lavorare così costringe a ragionare davvero sull’organizzazione delle informazioni, perché ordinarle non basta più, occorre definire i contesti semantici più adatti. E rilancia, secondo lui, anche il concetto profondo di accessibilità per cui molte persone del settore si battono da anni.
RAG e chunking: i due termini da conoscere
RAG sta per retrieval-augmented generation, una tecnica descritta nel 2020 da Patrick Lewis e colleghi. Prima di generare una risposta, il sistema recupera i passaggi più pertinenti da una base di conoscenza, confrontando l’embedding della domanda con quelli dei documenti, poi li consegna al modello come materiale di lavoro.
Il chunking è la fase che precede tutto: spezzare i contenuti in porzioni, i chunk appunto, abbastanza piccole da risultare precise e abbastanza ampie da restare comprensibili. Qui chi scrive e organizza testi ha parecchio da dire. Un frammento tagliato male separa una domanda dalla sua risposta, mescola argomenti diversi, perde il titolo che gli dava contesto. Decidere dove dividere, a conti fatti, è una scelta di architettura dell’informazione e di content design.
Cosa può fare oggi chi lavora in UX
Qualche spunto pratico per iniziare:
- Usare gli embedding per un primo raggruppamento esplorativo di inventari di contenuti molto grandi, da confrontare poi con i risultati di un card sorting reale.
- Scovare duplicati e sovrapposizioni: due pagine con vettori quasi identici probabilmente rispondono allo stesso bisogno.
- Verificare la coerenza delle etichette, controllando se una voce di menu è semanticamente vicina alle pagine che raccoglie.
- Curare struttura, titoli e paragrafi pensando anche al recupero automatico, cosa che aiuta pure la visibilità nei motori generativi (ne ho parlato nel passaggio da SEO a GEO).
- Sedersi accanto a chi sviluppa quando si decidono le strategie di chunking, invece di lasciarle a un parametro di default.
I limiti da tenere presenti
Uno spazio semantico calcolato da un modello riflette i testi su cui quel modello è stato addestrato, con i relativi bias e le lacune su domini specialistici o lingue meno rappresentate. La vicinanza statistica, inoltre, non coincide sempre con il modello mentale delle persone: due termini possono comparire spesso insieme senza che nessuno li cerchi nello stesso posto.
Per questo gli embedding servono a generare ipotesi, mentre la conferma spetta alla ricerca con persone in carne e ossa, come ho già sostenuto a proposito degli utenti sintetici.
La terza domanda è quella che conta
Alla fine di questo ragionamento, una convinzione mi resta salda: la logica ha sfaccettature molto personali e spesso sorprendenti. Il cosiddetto buon senso, a guardarlo da vicino, è tutt’altro che comune, e un raggruppamento costruito sulla media statistica rischia di risultare poco inclusivo e piuttosto omologato. Rimane comunque una solida base di partenza su cui costruire le architetture di contenuti, purché venga poi validata da una ricerca altrettanto rigorosa.
Risorse correlate
- Tre domande secche sull’architettura dell’informazione e gli embedding, Stefano Bussolon, post LinkedIn e commenti
- Efficient Estimation of Word Representations in Vector Space, Tomas Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean, 2013
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis et al., NeurIPS 2020
- Embeddings: embedding space and static embeddings, Google Machine Learning Crash Course
- Information Architecture: For the Web and Beyond, Louis Rosenfeld, Peter Morville, Jorge Arango, O’Reilly, 4a edizione
- cardsort: a Python package to cluster and visualize data from open card sorting tasks, documentazione
